7장 마이크로서비스 쿼리 구현
7장 마이크로서비스 쿼리 구현
목차
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
7장 마이크로서비스 쿼리 구현
7.1 API 조합 패턴 응용 쿼리
__7.1.1 findOrder( ) 쿼리
__7.1.2 API 조합 패턴 개요
__7.1.3 API를 조합 패턴으로 findOrder( ) 쿼리 구현
__7.1.4 API 조합 설계 이슈
__7.1.5 API 조합 패턴의 장단점
7.2 CQRS 패턴
__7.2.1 CQRS의 필요성
__7.2.2 CQRS 개요
__7.2.3 CQRS의 장점
__7.2.4 CQRS의 단점
7.3 CQRS 뷰 설계
__7.3.1 뷰 DB 선택
__7.3.2 데이터 접근 모듈 설계
__7.3.3 CQRS 뷰 추가 및 업데이트
7.4 CQRS 뷰 구현: aws DynamoDB 응용
__7.4.1 OrderHistoryEventHandlers 모듈
__7.4.2 DynamoDB 데이터 모델링 및 쿼리 설계
__7.4.3 OrderHistoryDaoDynamoDb 클래스
7.5 마치며
정리 전략?
- 전부 정리는 NO
- 핵심중에서 꼭 적고 가야겠다 싶은 것만!
- 나의 생각을 섞어서 적을것..!
- 떠오르는 것 먼저 간단하게..!
내용
7장 마이크로서비스 쿼리 구현
7.1 API 조합 패턴 응용 쿼리
**7.1.1 findOrder( ) 쿼리
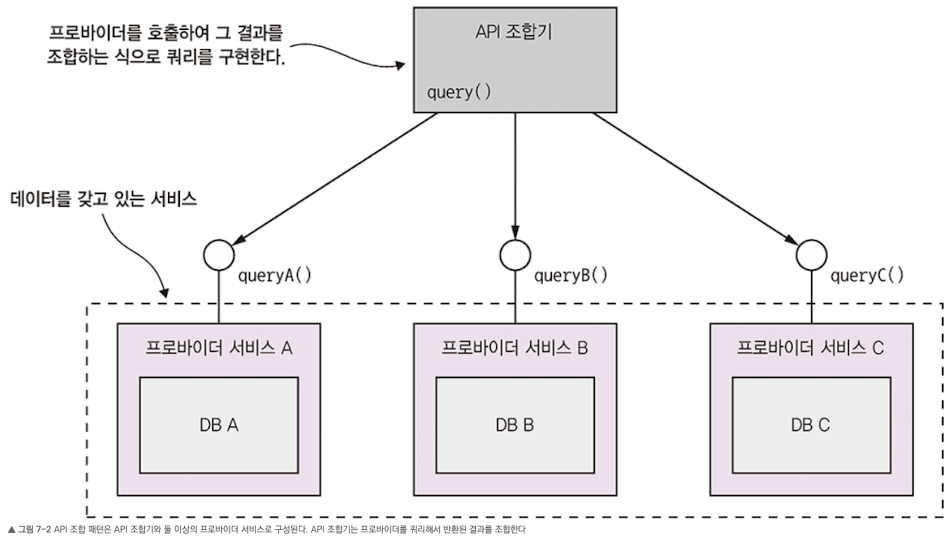
- API 조합 패턴은 데이터를 가진 서비스를 호출한 후 그 반환 결과를 조합해서 가져온다. 이 과정에서 두 종류의 참여자가 개입한다.
- API 조합기: 프로바이더 서비스를 쿼리하여 데이터를 조회한다.
- 프로바이더 서비스: 최종 결과로 반환한 데이터의 일부를 갖고 있는 서비스
**7.1.2 API 조합 패턴 개요
- 말그대로다 API를 조합해서 데이터를 얻어낸다는 것이다.
- 해당 조합을 어디서 하느냐에 따라 종류가 달라지는 데 클라이언트, API 게이트 웨이,API에서 진행할수도 있다.
**7.1.3 API를 조합 패턴으로 findOrder( ) 쿼리 구현
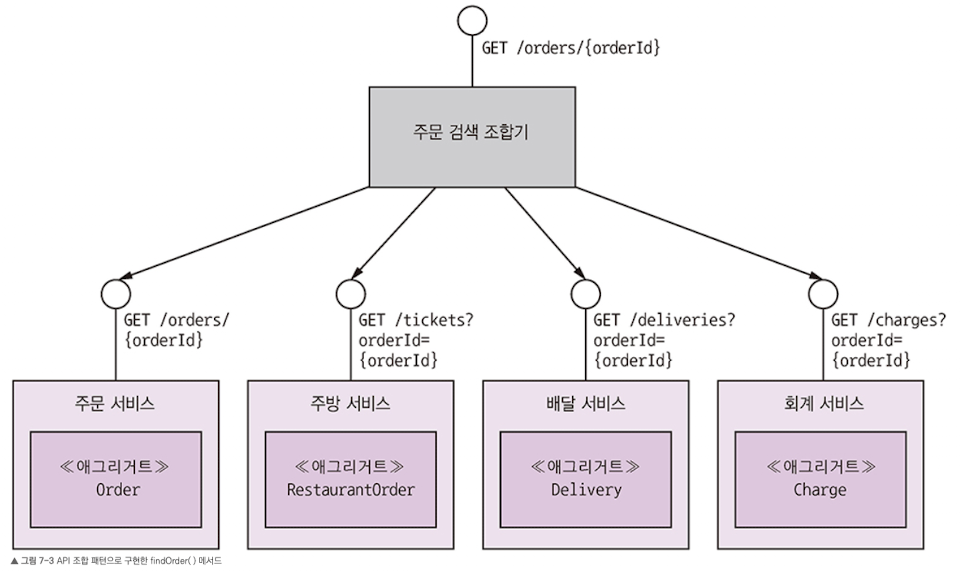
- 여기서 API 조합기는 쿼리를 REST 끝점으로 표출한 서비스다. HTTP 대신 gRPC 같은 다른 IPC 프로토콜을 사용하는 서비스 역시 개념은 같다. REST 끝점 GET / order/{orderId}가 구현된 주문 검색 조합기는 orderId로 네 서비스를 호출한 후 수신한 응답을 조인한다.
**7.1.4 API 조합 설계 이슈
- API 조합 패턴에는 두 가지 설계 이슈가 존재한다.
- 어느 컴포넌트를 쿼리 작업의 API 조합기로 선정할 것인가?
- 어떻게 해야 효율적으로 취합 로직을 작성할 것인가?
- 서비스 클라이언트를 API 조합기로 만든다.
- 주문 상태 뷰를 구현한 웹 애플리케이션 같은 클라이언트가 동일한 LAN에서 실행 중이라면 가장 효율적으로 주문 내역을 조회할 수 있다. 하지만 클라이언트가 방화벽 외부에 있고 서비스가 위치한 네트워크가 느리다면 그리 실용적이지 않다. (8장)
- 애플리케이션의 외부 API 게이트웨이를 API 조합기로 만든다.
- API 조합기를 StandAlone 서비스로 구현한다.
- standalone type
- 시스템에 독자적으로 프로세스가 구동되어 서비스를 제공하는 데몬을 말한다.
- 예를 들면, 웹서버(httpd), DB 서버(mysqld), 센드메일 서버(sendmail) 등이 있다.
- 출처: https://sinpk.tistory.com/entry/서비스-운영방식-standalone과-xinetd [IT:티스토리]
- standalone type
**7.1.5 API 조합 패턴의 장단점
- 가능하면 이 패턴으로 마이크로서비스 쿼리를 구혆하도록 권고하지만, 데이터가 복잡하고, 규모가 커지면 내부적으로 조인의 비용이 너무 커져서 성능, 메모리 이슈가 있을수 있다.
- 오버헤드가 증가한다
- 데이터 일관성이 결여된다.
- 가용성이 저하될 우려가 있다.
- 이러한 단점에도 API 조합 패턴은 쿼리 기능을 쉽게 구현할 수 있는 수단으로 매우 유용하다. 효율적으로 구현하기 어려운 (거대한 데이터를 인 메모리 조인하는) 쿼리 작업은 CQRS 패턴으로 구현하는 것이 현명하다.
7.2 CQRS 패턴
**7.2.1 CQRS의 필요성
- API 조합패턴으로 만들어낼수 없는, 또는 효율이 너무 안나오는 마이크로 서비스쿼리를 구현할때 필요함.
- findOrderHistory() 쿼리 구현
- findOrder()와 비슷하지만 모든 프로바이더 서비스가 필터/정렬의 속성을 보관하지 않아 기존 방식으로 해결하기 어렵다.
- findOrderHistory(): 아래의 매개변수를 받아 소비자의 주문 이력을 조회하는 쿼리 작업 (다건)
- 이거를 API 조합패턴으로 한다면..
- 첫째, API 조합기로 데이터를 인 메모리 조인한다. 그러나 거대한 데이터 뭉치를 이런 식으로 API 조합기에서 조인하면 급격히 효율이 떨어진다.
- 둘째, API 조합기로 주문 서비스, 주방 서비스에서 데이터를 조회하고, 주문 ID를 이용하여 다른 서비스에 있는 데이터를 요청한다. 하지만 이는 해당 서비스가 대량 조회 API를 제공할 경우에만 가능한 방법이다. 그렇다고 주문 데이터를 하나하나 요청하는 것은 과도한 네트워크 트래픽이 유발되므로 비효율적이다.
- 어려운 단일 서비스 쿼리: findAvailableRestaurants()
- 관심사를 분리할 필요성
**7.2.2 CQRS 개요
- 일단 이거 할려면 뷰를 위한 데이터 베이스 설계하고, 뷰를 어떻게 업데이트 할지? 뷰를 조회하는 쿼리는 어떻게 짤지? 그리고 그러한 구성어떻게 할지에 대한 고민을 해두면 된다.
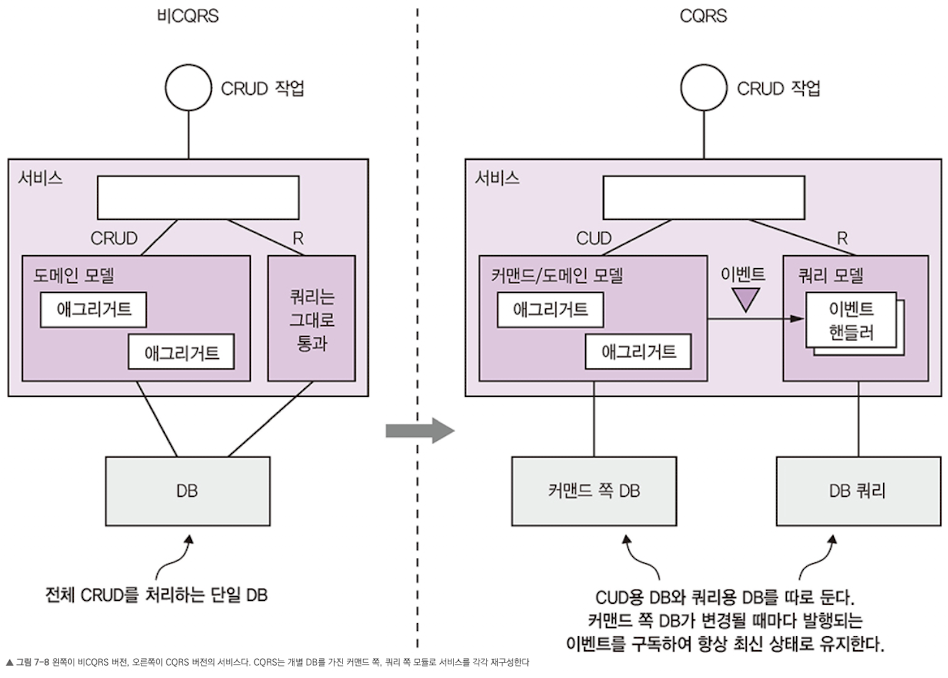
- CQRS는 이름에서 볼 수 있듯이 관심사의 분리/구분에 관한 패턴이다. 이 패턴은 영속적 데이터 모델과 그것을 사용하는 모듈을 커맨드와 쿼리, 두 개로 가른다.
- 생성/수정/삭제 (CUD, HTTP POST, PUT, DELETE) 기능은 커맨드 쪽 모듈 및 데이터 모델에 구현
- 조회 (R, HTTP GET) 기능은 쿼리 쪽 모듈 및 데이터 모델에 구현
**7.2.3 CQRS의 장점
- 책임의 분리로 코드가 유지보수하기 쉬워짐.
- 한번 뷰를 구축하면 데이터 조회하기 편함.
- 효율적 쿼리 구현
- CQRS는 이벤트 소싱의 한계 (이벤트 저장소는 기본키 쿼리만 지원)을 극복하게 해준다.
**7.2.4 CQRS의 단점
- 뷰를 구축하는데 비용이 들음.
- 아키텍처 복잡
- 복제 시차를 신경써야한다
- 커맨드/쿼리 양쪽 뷰사이의 랙(lag)을 처리해야 한다.
- 커맨드/쿼리 양쪽 API가 클라이언트에 버전 정보를 전달해서 해당 데이터가 업데이트가 된 애그리거트에서 가져온 건지 분간하게 만드는 것이다. 이 경우 클라이언트는 최신 데이터를 받을 때 까지 쿼리 쪽 뷰를 계속 폴링한다.
- 네이티브 모바일 앱이나 SPA (Single Page Application) 같은 UI 애플리케이션은 쿼리를 하지 않고 커맨드가 성공하면 자신의 로컬 모델을 업데이트 하는 방법으로 랙을 해소할 수 있다.
7.3 CQRS 뷰 설계
- DB 를 선정하고 스키마를 설계해야한다.
- 데이터 접근 모듈 설계시 멱등/동시 업데이트 등에 대해 고려해야 한다.
- 스키마 변경시 뷰를 효율적으로 재 빌드(적용) 할 방법을 강구해야 한다.
- COMMAND 로 변경된 데이터를 QUERY 에 복제하는 시차를 어떻게 처리해야 할지 결정해야한다.
**7.3.1 뷰 DB 선택
- NoSQL은 대부분 트랜잭션 기능이 제한적이고 범용적인 쿼리 능력은 없지만, 유연한 데이터 모델, 우수한 성능/확장성 등 SQL 기반 DB보다 나은 경우가 있다.
- NoSQL DB는 CQRS 뷰와 잘 맞는다.
- NoSQL DB의 데이터 모델과 우수한 성능 역시 CQRS 뷰에 유리하다.
- CQRS 뷰는 단순 트랜잭션만 사용하고 고정된 쿼리만 실행하므로 NoSQL DB의 제약 사항에도 영향을 받지 않는다.
- 물론 SQL DB를 사용해서 CQRS 뷰를 구현하는 것이 좋은 경우도 있다.
- 최신 하드웨어에서 실행되는 최신 RDBMS는 예전보다 성능이 뛰어나고, 아무래도 대부분의 IT 종사자들은 SQL DB가 더 익숙하다.
- SQL DB는 확장판을 설치해서 비관계형 기능 (ex: 지리 공간 데이터형 쿼리)를 추가할 수 있다.
**7.3.2 데이터 접근 모듈 설계
- 동시성 처리
- DAO 레코드를 읽고 업데이트된 레코드를 쓴다면 낙관적 잠금, 비관적 잠금이든 둘중 하나를 적용해야 한다.
- DB레코드를 먼저 읽지 않고 업데이트하는 방식도 있긴함.
- 멱등한 이벤트 핸들러
- 중복 이벤트 때문에 부정확한 결과가 나온다면 멱등한 이벤트 핸들러가 아니다. 가령 은행 잔고를 증가시키는 이벤트는 당연히 멱등하지 않다. 비멱등적 이벤트 핸들러는 자신이 뷰 데이터 저장소에서 처리한 이벤트 ID를 기록해 두었다가 중복 이벤트가 들어오면 솎아내야 한다.
- 이벤트 핸들러는 반드시 이벤트 ID를 기록하고 데이터 저장소를 원자적으로 업데이트 해야 한다. 뷰 데이터 저장소가 SQL DB일 경우, 이벤트 핸들러가 처리완료한 이벤트를 뷰 업데이트 트랜잭션 일부로 PROCESSED_EVENTS 테이블에 삽입할 수 있다. 그러나 NoSQL DB인 경우, 이벤트 핸들러는 자신이 업데이트하는 데이터 저장소 ‘레코드’ (MongoDB의 도큐먼트, DynamoDB의 테이블 아이템)에 이벤트를 저장해야 한다.
**7.3.3 CQRS 뷰 추가 및 업데이트
- 아카이빙된 이벤트를 이용하여 CQRS 뷰 구축
- 우선 메시지 브로커는 메시지를 무기한 보관할 수 없다. 그러므로 필요한 이벤트를 메시지 브로커에서 전부 읽기만 해서는 뷰를 구축할 수 없다. 이를테면 aws S3 같은 곳에 아카이빙된, 더 오래된 이벤트도 같이 가져와야 한다. 아파치 스파크처럼 확장 가능한 빅데이터 기술을 응용하면 가능하다
- CQRS 뷰를 단계적으로 구축
- 전체 이벤트를 처리하는 시간/리소스가 점점 증가하는 것도 뷰 생성의 다른 문제점이다. 결국 뷰는 너무 느려지고 비용도 많이 들 것이다. 해결 방법은 2단계 증분 알고리즘 (two-step incremental algorithm)을 적용하는 것이다.
- 1단계는 주기적으로 각 애그리거트의 인스턴스의 스냅샷을 그 이전의 스냅샷과 이 스냅샷이 생성된 이후 죽 발생한 이벤트를 바탕으로 계산한다.
- 2단계는 이렇게 계산된 스냅샷과 그 이후 발생한 이벤트를 이용하여 뷰를 생성한다.
7.4 CQRS 뷰 구현: aws DynamoDB 응용
- 뷰를 위한 db로 aws에서 제공하는 DynamoDB를 응용하는 것도 방법임.
addOrder() 메서드
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
@Override
public boolean addOrder(Order order, Optional<SourceEvent> eventSource) {
UpdateItemSpec spec = new UpdateItemSpec()
.withPrimaryKey("orderId", order.getOrderId()) // 업데이트할 Order 기본 키
.withUpdateExpression("SET orderStatus = :orderStatus, " + // 속성을 업데이트 하는 표현 식
"creationDate = :creationDate, consumerId = :consumerId, lineItems =" +
" :lineItems, keywords = :keywords, restaurantId = :restaurantId, " +
" restaurantName = :restaurantName"
)
.withValueMap(new Maps() // 업데이트 표현식의 자리끼우개 값들
.add(":orderStatus", order.getStatus().toString())
.add(":consumerId", order.getConsumerId())
.add(":creationDate", order.getCreationDate().getMillis())
.add(":lineItems", mapLineItems(order.getLineItems()))
.add(":keywords", mapKeywords(order))
.add(":restaurantId", order.getRestaurantId())
.add(":restaurantName", order.getRestaurantName())
.map())
.withReturnValues(ReturnValue.NONE);
return idempotentUpdate(spec, eventSource);
}
- addOrder()는 order, eventSource 두 매개변수를 받아 ftgo-order-history 테이블에 Order를 추가하는 메서드.
- addOrder()는 aws SDK의 일부로서 업데이트 작업이 기술된 UpdateItemSpec를 생성하고, 중복 업데이트를 방지하는 조건부 표현식을 추가한 후 업데이트를 수행하는 헬퍼 메서드 idempotentUpdate()를 호출한다.
idempotentUpdate() 메서드
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
private boolean idempotentUpdate(UpdateItemSpec spec, Optional<SourceEvent> eventSource) {
try {
table.updateItem(eventSource.map(es -> es.addDuplicateDetection(spec))
.orElse(spec));
return true;
} catch (ConditionalCheckFailedException e) {
logger.error("not updated {}", eventSource);
// Do nothing
return false;
}
}

...

public UpdateItemSpec addDuplicateDetection(UpdateItemSpec spec) {
HashMap<String, String> nameMap = spec.getNameMap() == null ? new HashMap<>() : new HashMap<>(spec.getNameMap());
nameMap.put("#duplicateDetection", "events." + aggregateType + aggregateId);
HashMap<String, Object> valueMap = new HashMap<>(spec.getValueMap());
valueMap.put(":eventId", eventId);
return spec.withUpdateExpression(String.format("%s , #duplicateDetection = :eventId", spec.getUpdateExpression()))
.withNameMap(nameMap)
.withValueMap(valueMap)
.withConditionExpression(Expressions.and(spec.getConditionExpression(), "attribute_not_exists(#duplicateDetection) OR #duplicateDetection < :eventId"));
}
- sourceEvent를 받은 idempotentUpdate()는 SourceEvent.addDuplicateDetection()를 호출해서 방금 전 설명한 조건부 표현식을 UpdateItemSpec에 추가한다. 그리고 중복 이벤트일 경우 updateItem()이 던진 ConditionalCheckFailedException 예외를 붙잡아 아무 동작도하지 않는다.
findOrderHistory() 메서드
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
@Override
public OrderHistory findOrderHistory(String consumerId, OrderHistoryFilter
filter) {

    QuerySpec spec = new QuerySpec()
            .withScanIndexForward(false) // 최근 순서대로 주문 목록을 반환하도록 지정
            .withHashKey("consumerId", consumerId)
            .withRangeKeyCondition(new RangeKeyCondition("creationDate").gt // 반환할 주문일자의 최댓값
                    (filter.getSince().getMillis()));

    filter.getStartKeyToken().ifPresent(token -> spec.withExclusiveStartKey
            (toStartingPrimaryKey(token)));

    Map<String, Object> valuesMap = new HashMap<>();

    String filterExpression = Expressions.and( // 필터 표현식을 만들고 OrderHistoryFilter에서 가져온 맵으로 자리끼우개 값 세팅
            keywordFilterExpression(valuesMap, filter.getKeywords()),
            statusFilterExpression(valuesMap, filter.getStatus()));

    if (!valuesMap.isEmpty())
      spec.withValueMap(valuesMap);

    if (StringUtils.isNotBlank(filterExpression)) {
      spec.withFilterExpression(filterExpression);
    }

    System.out.print("filterExpression.toString()=" + filterExpression);

    filter.getPageSize().ifPresent(spec::withMaxResultSize); // 호출부가 페이기 크기를 지정했다면 그에 맞개 결과 개수를 제한

    ItemCollection<QueryOutcome> result = index.query(spec);

    return new OrderHistory(StreamSupport.stream(result.spliterator(), false)
            .map(this::toOrder).collect(toList()), // 조회 결과 반환된 항목으로 Order 생성
            Optional.ofNullable(result.getLastLowLevelResult().getQueryResult
                    ().getLastEvaluatedKey()).map(this::toStartKeyToken));

}
7.5 마치며
- 각 서비스 데이터는 프라이빗하기 때문에 여러 서비스의 데이터를 가져오는 쿼리는 구현하기 쉽지 않다.
- 여러 서비스에서 데이터를 조회하는 쿼리는 크게 API 조합 패턴과 CQRS로 구현된다.
- 여러 서비스에서 데이터를 취합하는 API 조합 패턴은 쿼리를 구현하기 가장 간편한 방법이므로 가능하다면 많이 사용하는 것이 좋다.
- API 조합 패턴은 쿼리가 조금만 복잡해져도 대량 데이터를 인메모리 조인해야 하므로 효율이 낮다.
- CQRS 패턴은 뷰 전용 DB를 이용하여 쿼리한다. 기능이 좋은만큼 구현이 어렵다.
- CQRS 뷰 모듈은 중복 이벤트 솎아내기, 동시 업데이트 처리 기능을 갖추어야 한다.
- CQRS를 사용하면 한 서비스가 다른 서비스가 소유한 데이터를 반환하는 쿼리 구현도 가능하므로 관심사 분리 관점에서 유리하다.
- 클라이언트는 CQRS 뷰의 최종 일관성을 처리해야 한다.
참고자료
https://velog.io/@daehoon12/%EB%A7%88%EC%9D%B4%ED%81%AC%EB%A1%9C%EC%84%9C%EB%B9%84%EC%8A%A4-%ED%8C%A8%ED%84%B4-7.-%EB%A7%88%EC%9D%B4%ED%81%AC%EB%A1%9C%EC%84%9C%EB%B9%84%EC%8A%A4-%EC%BF%BC%EB%A6%AC-%EA%B5%AC%ED%98%84#71-api-%EC%A1%B0%ED%95%A9-%ED%8C%A8%ED%84%B4-%EC%9D%91%EC%9A%A9-%EC%BF%BC%EB%A6%AC
https://freeend.tistory.com/113
This post is licensed under CC BY 4.0 by the author.