5주2일차_페이징처리및회적화사례실습
5주2일차_페이징처리및회적화사례실습
필기 가자
2.1 OFFSET이 큰 경우 성능 저하 발생 이유
- 문제 발생 원리:
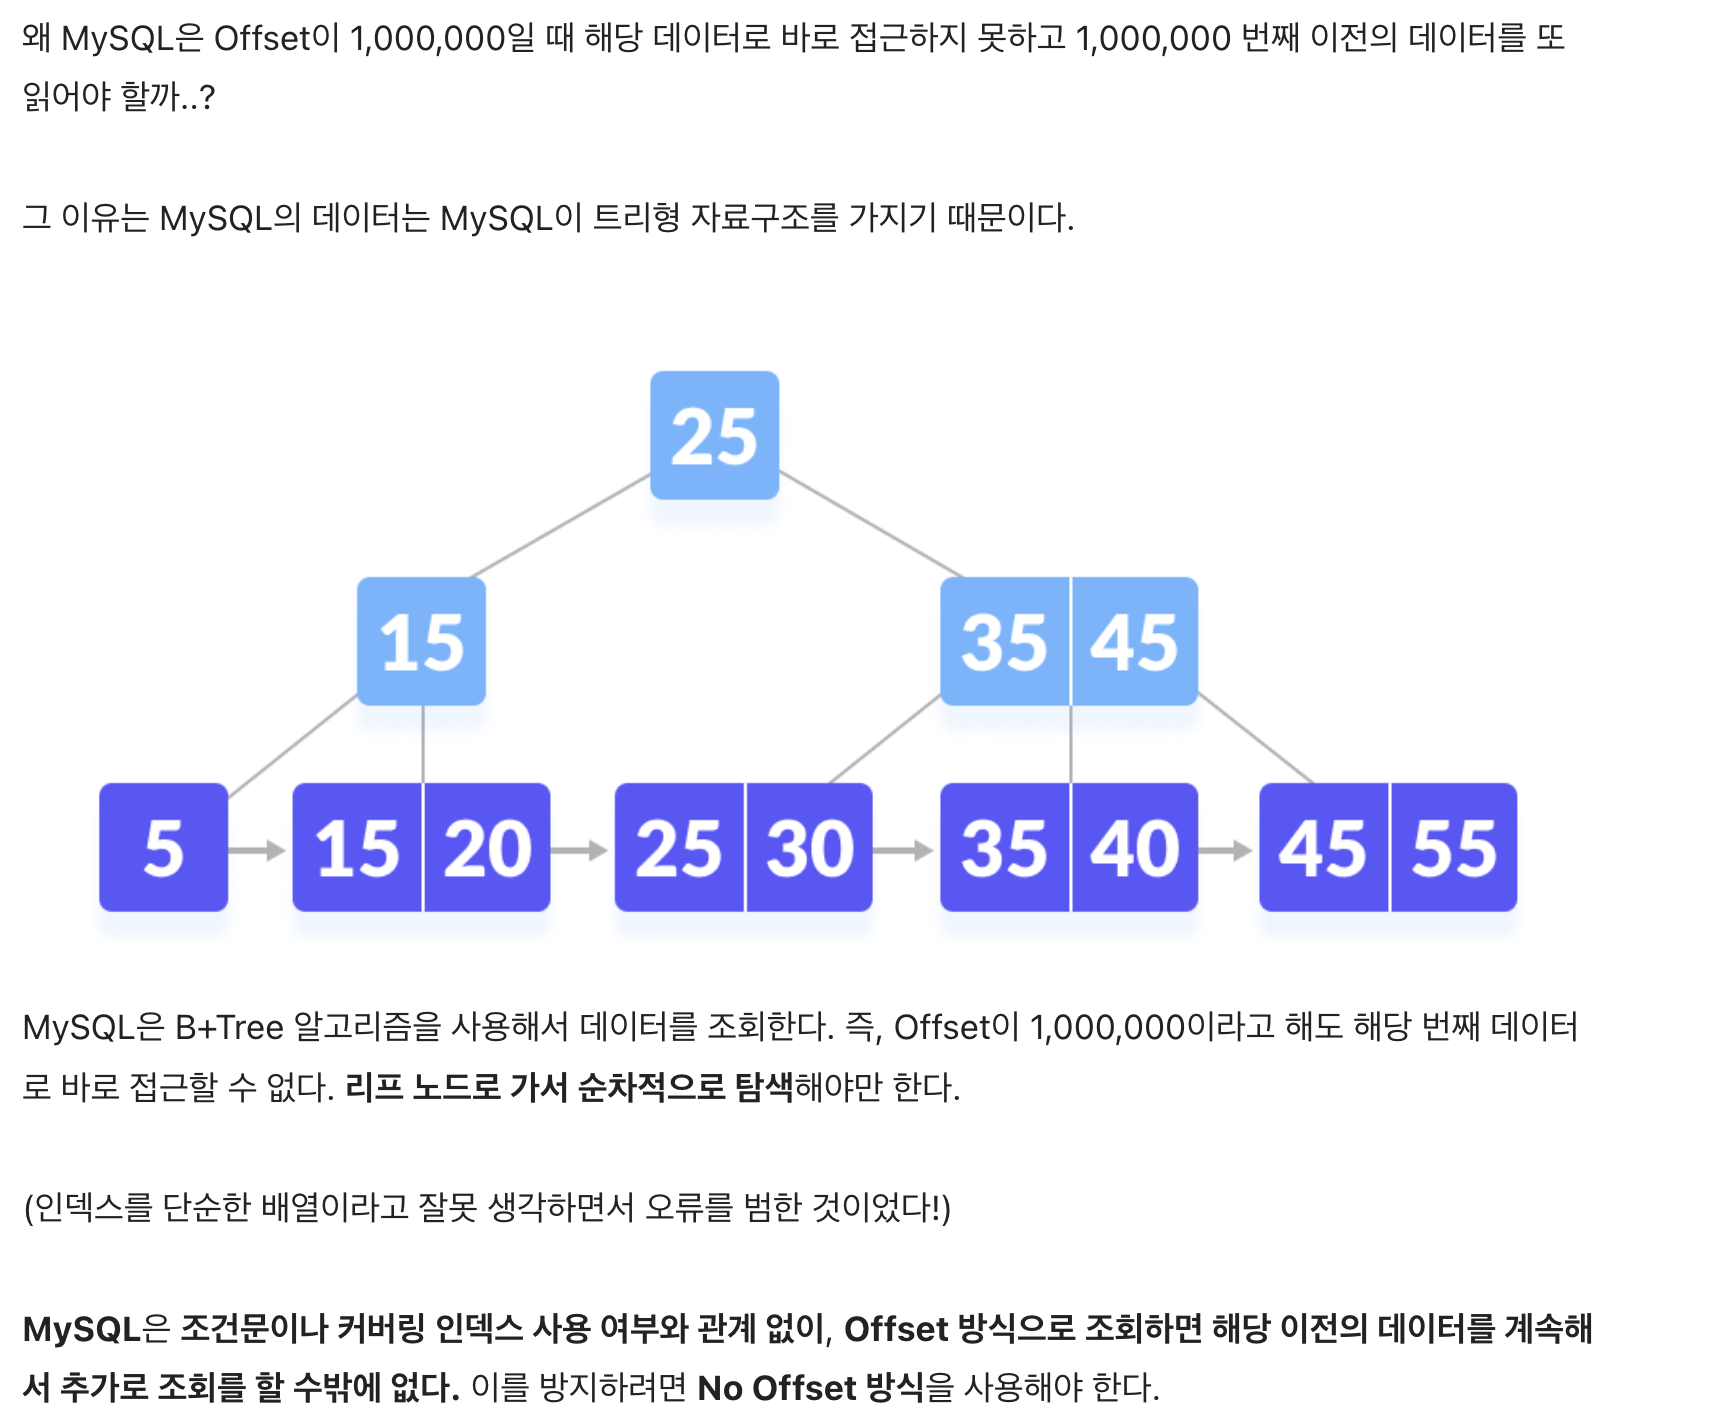
- 데이터베이스는 OFFSET에 지정된 값만큼 데이터를 건너뛰기 위해 결과 집합을 메모리에 로드하고, 해당 범위의 데이터를 모두 스캔(Discard)합니다.
- OFFSET의 값이 커질수록 건너뛰어야 하는 데이터가 많아지고, 이로 인해 쿼리 처리 시간이 급격히 증가합니다.
- 소규모 데이터베이스에서는 OFFSET 기반 페이징을 사용할 수 있지만, 대규모 데이터베이스에서는 성능 최적화가 필요합니다.
- 이를 해결하기 위해 Keyset Pagination 또는 인덱스를 활용한 최적화 전략을 도입해야 합니다.
3.1 Keyset Pagination (커서 기반 페이징)
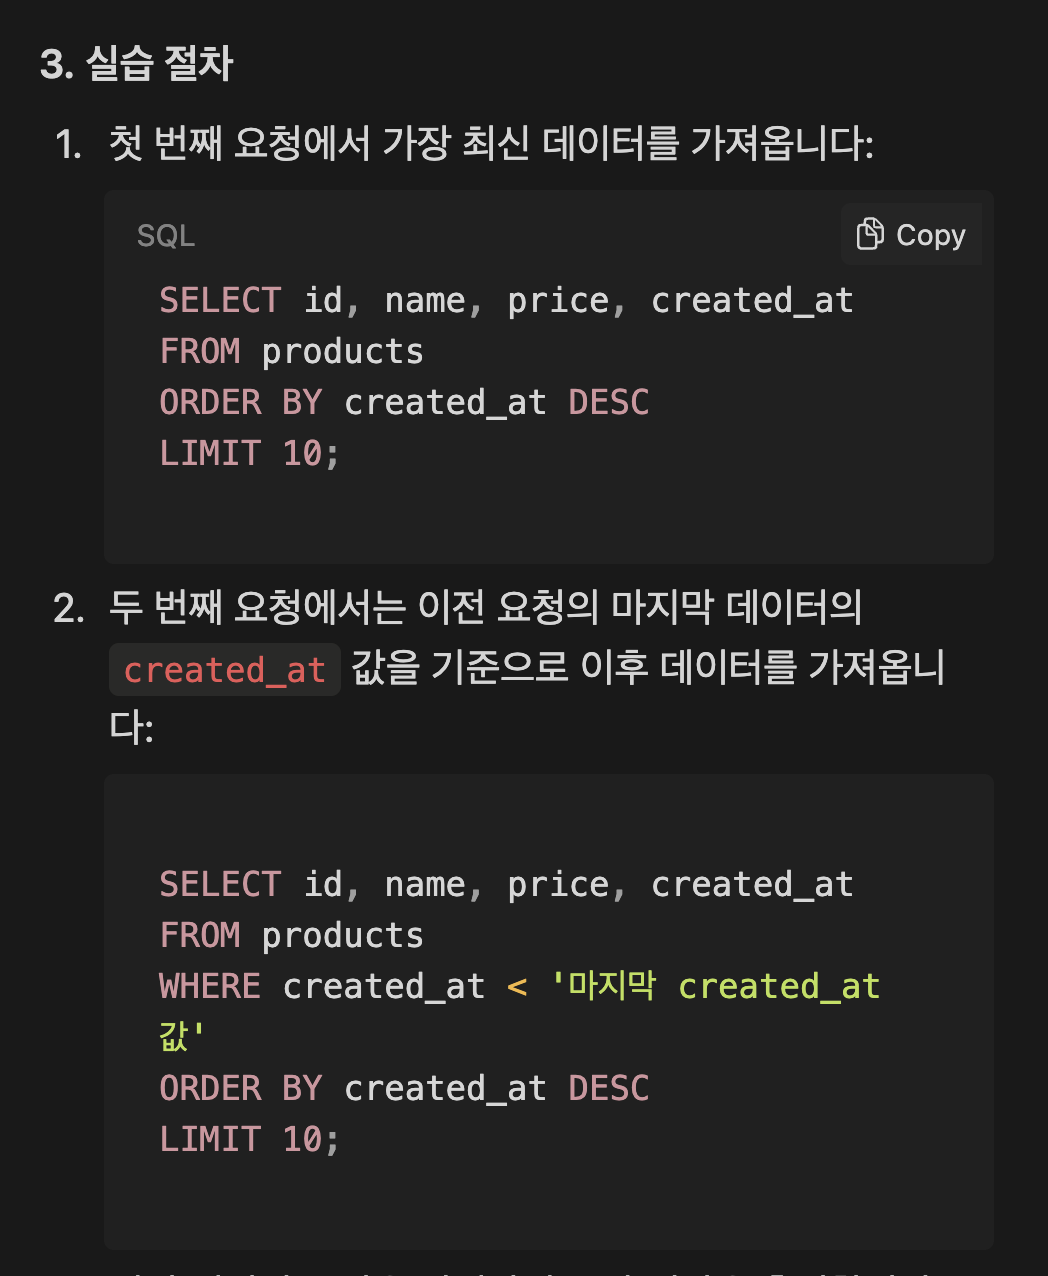
- Keyset Pagination은 OFFSET을 사용하지 않고, 이전 요청의 마지막 데이터 값을 기준으로 다음 데이터를 가져오는 방식입니다.
- 작동 방식:
- 특정 정렬 기준(Key)을 사용하여 이전 요청의 마지막 데이터를 기준으로 이후 데이터를 가져옵니다.
- OFFSET이 필요하지 않아 불필요한 데이터 스캔을 방지.
- 장점:
- 대규모 데이터에서도 일정한 성능 유지.
- 고정된 Key를 기반으로 필요한 데이터만 조회 가능.
- 단점:
- 정렬 기준(Key) 설정이 복잡할 수 있으며, 페이지 번호 기반 탐색이 어려움.
복합 인덱스:
category_id와created_at에 대한 복합 인덱스를 생성하면, 검색 조건 (WHERE)과 정렬 조건 (ORDER BY)을 인덱스가 모두 활용할 수 있습니다.이를 통해 테이블 스캔 대신 인덱스 범위 스캔으로 검색 성능이 향상됩니다.
- OFFSET/LIMIT 방식은 간단하지만 대량 데이터에서는 비효율적입니다.
- Keyset Pagination은 일정한 성능으로 안정적인 페이징을 제공하며 대규모 데이터에 적합합니다
2.2 복합 인덱스 주의사항
- 두 개 이상의 컬럼을 조합하여 생성된 인덱스.
- 특징:
- WHERE 조건에서 여러 컬럼이 함께 사용될 때 성능 향상.
- 컬럼의 순서가 중요: 인덱스는 정의된 순서대로만 동작.
- 사용 사례:
고객 ID와 주문 날짜를 동시에 조회할 때:
1
2
3
  CREATE INDEX idx_user_id_updated_at ON orders(user_id, updated_at);

  SELECT * FROM orders WHERE user_id = 1 AND updated_at > '2025-01-16';
주의사항:
- 정의된 순서와 일치하지 않는 단독 컬럼 조건에서는 인덱스가 완전히 활용되지 않을 수 있음.
- 예:
order_date단독 조건은idx_customer_order_date를 활용하지 못함.
혹시 마지막 문장은 팩트니? -> 확ㅣ
오프셋의 비밀
Action Plan
[x] 쿼리 실습
수업 내용 필기 정리.
- 이거는 수업 내용을 자세히 들으면 도움이 될듯.
- 복합 인덱스 쪽 도움이 됨.
- 원하는 파트만 실제로 성능 향상 있는지 확인은 필요해보임.
- 내가 해보니 항상 의도한대로 동작하는 것은 아니였음.
- 원하는 파트 설명만 추출할 방법, 프로세스 필요.
- 이 테스트를 자바로 수행할 방법? 빠르게 강구 해보기.
실습 결과
어디까지 생각해쓴가
- 실험 조건 파트 할 차례임.
This post is licensed under CC BY 4.0 by the author.