11주2일차_elasticsearch_데이터_집계_및_고급검색_kibana_대시보드
내용
- ElasticSearch 집계(Aggregation) 개요 1.1 Aggregation 이란 검색 결과를 기반으로 통계, 그룹화, 필터링 등의 연산을 수행하는 기능입니다. ElasticSearch의 Aggregation(집계) 기능은 검색된 데이터에서 특정 패턴을 분석하고 통계를 계산하는 기능입니다. 일반적인 SQL의 GROUP BY, SUM(), AVG() 같은 집계 함수와 유사하며, 대량의 데이터를 빠르게 분석할 수 있습니다
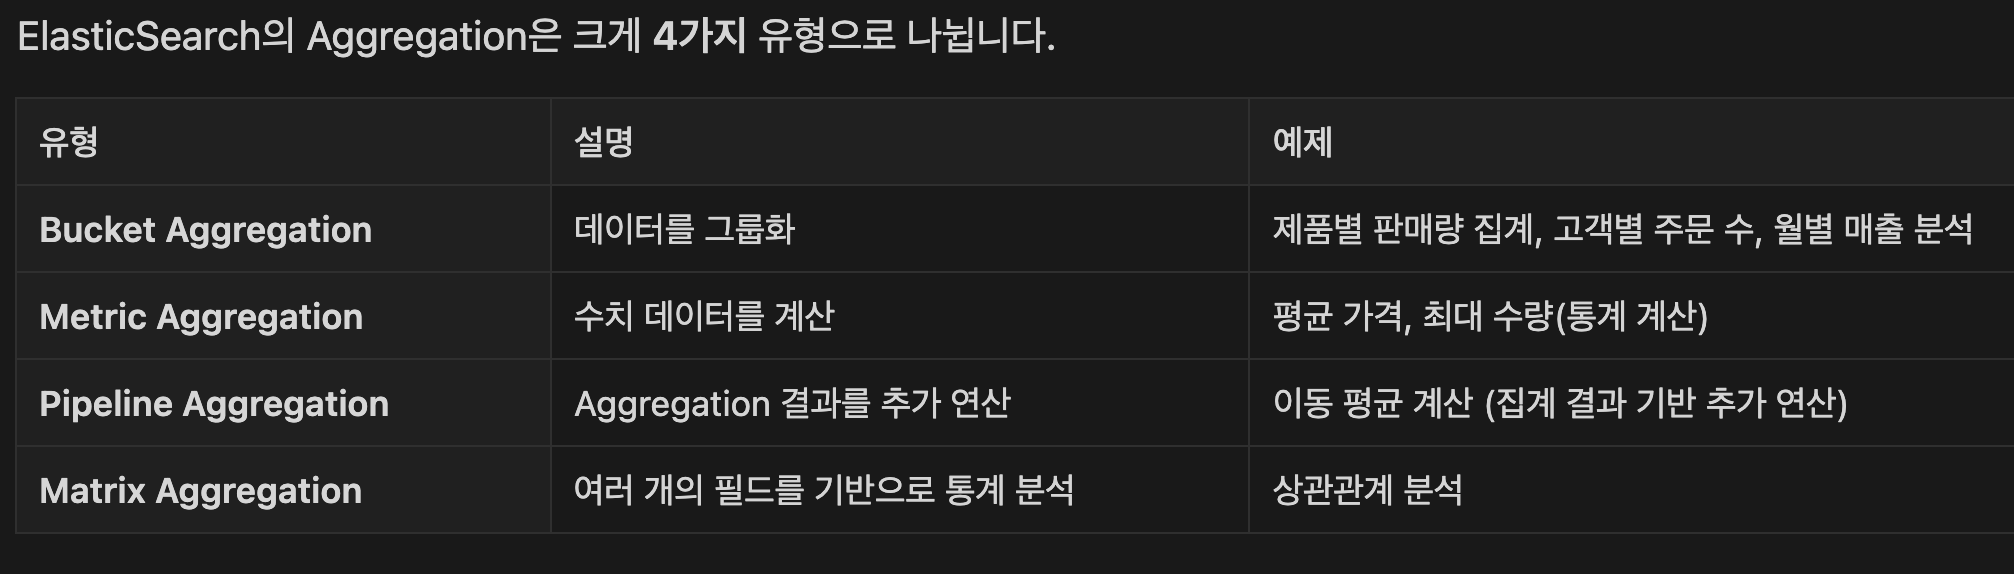
Bucket Aggregation 데이터를 그룹화 제품별 판매량 집계, 고객별 주문 수, 월별 매출 분석 Metric Aggregation 수치 데이터를 계산 평균 가격, 최대 수량(통계 계산) Pipeline Aggregation Aggregation 결과를 추가 연산 이동 평균 계산 (집계 결과 기반 추가 연산) Matrix Aggregation 여러 개의 필드를 기반으로 통계 분석
2.7 Matrix Aggregation (다중 필드 분석)
Matrix Aggregation은 여러 개의 필드 간의 관계를 분석하는 기능입니다.
2.7.1 상관관계 분석 (Correlation)
3.2 필요한 데이터만 가져오기 (size: 0)
- 검색 결과를 필요로 하지 않고 Aggregation 결과만 원할 경우
size: 0설정합니다.3.3.1
filter특징 - 검색 점수(Relevance Score)를 계산하지 않습니다.
- 캐싱을 활용하여 성능을 최적화합니다.
- 집계(Aggregation)와 함께 사용할 때 필수적입니다.
mustvsfilter
3.3.5 filter 정리
- 검색 점수가 필요 없을 때는
must대신filter사용 → 성능 향상됩니다. - 필터는 캐싱이 가능하여 반복 검색 시 속도가 빠릅니다.
- Aggregation과 함께 사용하면 불필요한 데이터 처리를 줄여 성능 최적화 가능합니다.
- ElasticSearch에서 필터링을 적절히 사용하면 검색 및 집계 성능을 크게 향상시킬 수 있습니다.
생각 정리.
- 그렇다면, db의 데이터를 엘라스틱서치로 주기적으로 인덱싱하여 관리하는가?
- 아니면 데이터 저장부터 엘라스틱 서치에 원본을 저장하는가?
생각 정리 질문에 대한 답변
DB의 데이터를 엘라스틱서치로 주기적으로 인덱싱하여 관리하는가?
장점: 기존 데이터베이스를 유지하면서 엘라스틱서치의 강력한 검색 및 집계 기능을 활용할 수 있습니다. 데이터베이스의 안정성과 엘라스틱서치의 성능을 동시에 누릴 수 있습니다. 단점: 데이터 동기화가 필요합니다. 주기적으로 데이터를 인덱싱해야 하므로, 실시간성이 떨어질 수 있습니다. 또한, 데이터 동기화 과정에서 일관성 문제가 발생할 수 있습니다. 데이터 저장부터 엘라스틱서치에 원본을 저장하는가?
장점: 실시간 데이터 검색 및 집계가 가능합니다. 데이터가 엘라스틱서치에 직접 저장되므로, 별도의 동기화 과정이 필요 없습니다. 데이터 일관성을 유지하기 쉽습니다. 단점: 엘라스틱서치는 데이터베이스로서의 기능이 제한적입니다. 트랜잭션 처리나 복잡한 관계형 데이터 모델링이 필요한 경우에는 적합하지 않을 수 있습니다. 또한, 엘라스틱서치의 데이터 저장소로서의 안정성은 전통적인 데이터베이스에 비해 낮을 수 있습니다.